返回项目列表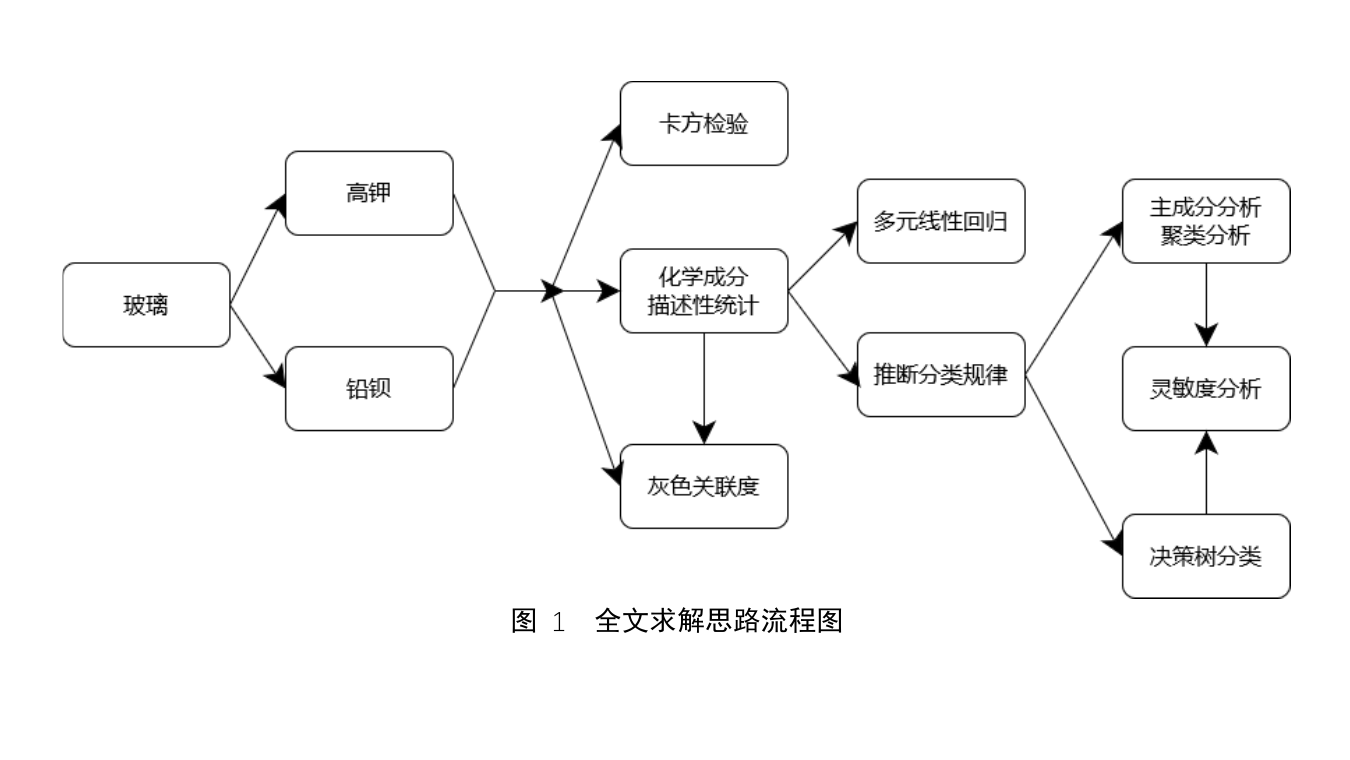
古代玻璃制品的成分分析与鉴别
从化学成分数据到玻璃类型识别的数学建模
代码实现 / 部分建模
2022(具体起止时间待补充)
待补充
省一等奖
2022-09-18
R
SPSS
随机森林
贝叶斯
多元回归
灵敏度分析
数学建模
数据分析
分类模型
文化遗产
案例速览
古代玻璃制品的成分分析与鉴别
- 背景 / 问题
- 如何从古代玻璃文物的表面特征与化学成分数据中分析风化规律、划分玻璃亚类,并识别未知样品类型。
- 我的角色与边界
- 主要负责代码实现,并参与部分建模工作;个人负责内容包括随机森林、贝叶斯、多元回归分析和灵敏度分析等。
- 关键决策 / 动作
- 使用 R、SPSS 完成数据处理和模型代码,重点承担随机森林、贝叶斯、多元回归与灵敏度分析
- 参与模型选择与调试,并与团队共同串联统计检验、回归、聚类和分类链路
- 通过不同分类方法对照和化学成分扰动,检验未知样品识别结果的稳定性
- 结果 / 验证状态
- 团队形成 37 页提交版论文,并获得省一等奖。
- 关键产物
- 数学建模提交版论文 已形成
- 模型代码实现 已形成
- 省一等奖 已形成
项目概述
这是 2022 年高教社杯全国大学生数学建模竞赛 C 题“古代玻璃制品的成分分析与鉴别”。古代玻璃在埋藏和保存过程中会发生不同程度的表面风化,玻璃类型、文物表面特征与化学成分之间也存在复杂关系。团队从已有文物数据出发,分析风化规律和成分变化,继续划分高钾玻璃与铅钡玻璃的亚类,并对未知样品进行类型鉴别,最终获得省一等奖。
痛点机会
数据分析面临三类困难。首先,部分样品的成分比例总和不满足有效范围,数据中还存在缺失值,需要先判断哪些记录能够进入后续建模。其次,风化状态、玻璃类型、纹饰、颜色与多种化学成分同时存在,单一统计量难以解释它们之间的关系。最后,未知样品的类别判断不仅要给出结果,还需要比较不同分类方法,并通过成分扰动检验结论是否稳定。
目标指标
项目需要完成五项任务:检验表面风化与玻璃类型、纹饰和颜色的关系;分析两类玻璃风化前后的化学成分变化;为高钾与铅钡玻璃建立可解释的亚类划分;识别未知样品所属类型并验证分类稳定性;分析不同化学成分之间的关联关系。团队需要在有限赛程内完成数据清洗、模型比较、稳定性验证和论文表达。
用户调研
建模前先对附件数据进行有效性检查。论文将成分比例总和不在 85% 至 105% 范围内的记录视为异常,并结合缺失情况清理数据。随后从风化状态、类型、纹饰、颜色和化学成分多个维度进行描述性观察,为统计检验、成分预测和分类建模确定变量关系与处理顺序。这里记录的是数据研究过程,不代表另行开展了用户访谈或田野调查。
方案设计
模型采用分层组合方案。团队先用卡方检验判断表面风化与玻璃类型、纹饰、颜色是否相关,再通过描述性统计和多元线性回归分析两类玻璃风化前后的成分变化。亚类划分阶段先用主成分分析压缩高维化学成分,再对比系统聚类与 K-means 聚类结果。未知样品鉴别以决策树和朴素贝叶斯作为论文主要分类链路,并对关键成分施加扰动完成灵敏度分析;个人代码实验还包括随机森林。最后用灰色关联分析解释不同化学成分之间的联系。
落地推进
论文先排除成分总和异常且存在缺失的样品,再分别建立风化关系、成分变化、亚类划分和未知样品鉴别模型。我的工作以代码实现为主,并参与部分建模:使用 R、SPSS 处理数据和验证模型,重点负责随机森林、贝叶斯、多元回归分析与灵敏度分析等实现。团队用不同聚类方法交叉比较亚类结构,用决策树与贝叶斯相互验证未知样品结果,并改变关键化学成分比例观察预测是否变化。
效果复盘
论文结果显示,表面风化与玻璃类型存在较强相关性,而与颜色、纹饰的相关性不明显;高钾玻璃与铅钡玻璃在风化前后呈现不同的成分变化。主成分分析结合两种聚类方法形成了两类玻璃的亚类划分方案,决策树和贝叶斯对未知样品给出了相互一致的主要分类结论,灵敏度分析用于检查结果稳定性,灰色关联分析则补充了成分关系解释。团队完成 37 页提交版论文,最终获得省一等奖。
迭代反思
这套方案通过多种模型互相验证,提高了分类过程的可解释性,但仍受样本规模、异常值规则和化学成分测量误差影响。回看这次协作,代码实现不只是把公式翻译成程序,还需要持续核对数据假设、模型输出与论文结论是否一致。后续可以补充交叉验证、类别不平衡评估与更清晰的误差分析,并把数据预处理、模型选择和参数敏感性整理成更完整的可复现链路。
建模过程与关键图示
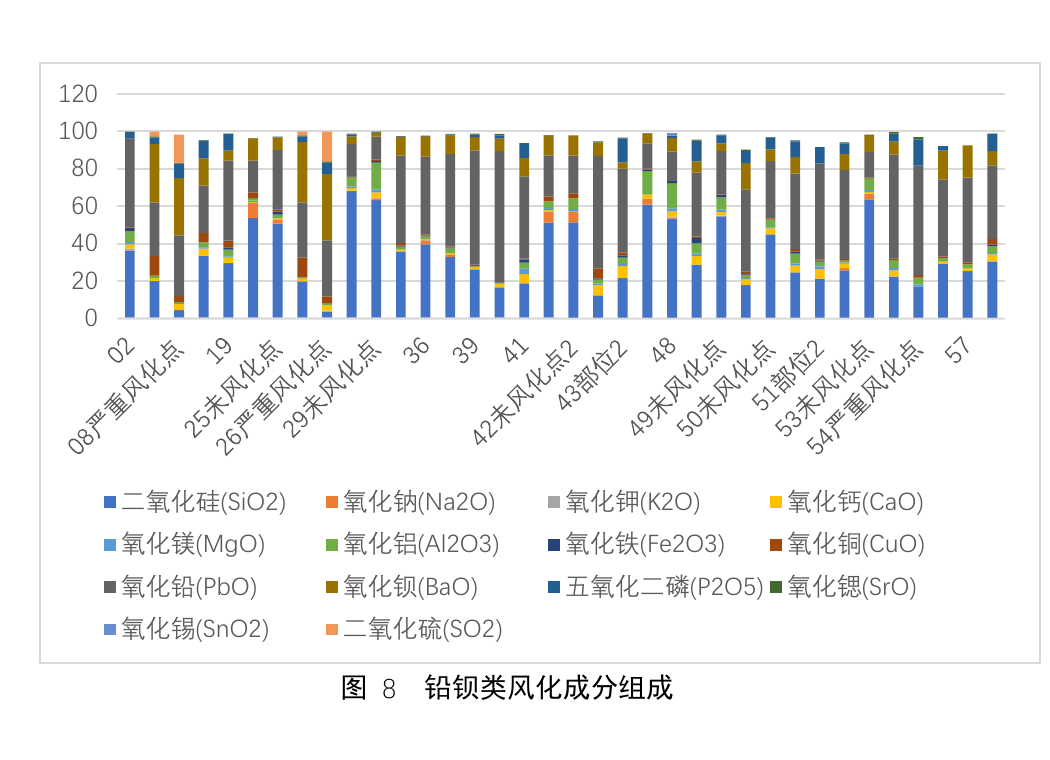
论文图 8:铅钡类玻璃风化成分组成,由此进入风化前化学成分预测与多元回归分析。
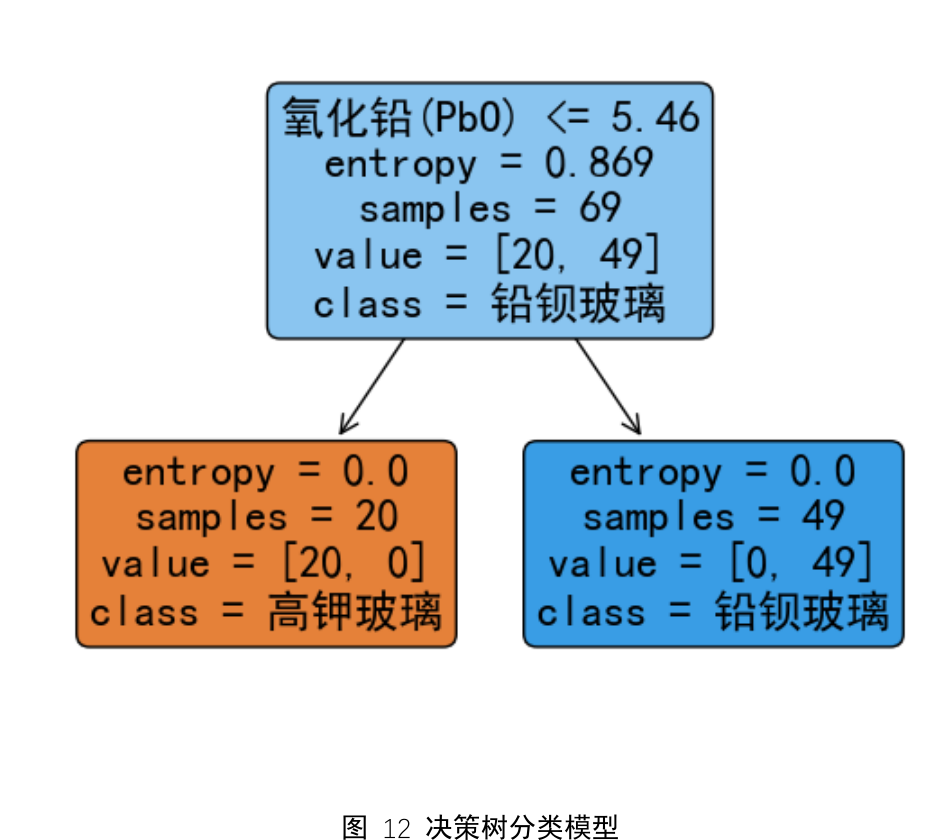
论文图 12:以氧化铅含量为关键划分条件的决策树分类结果。
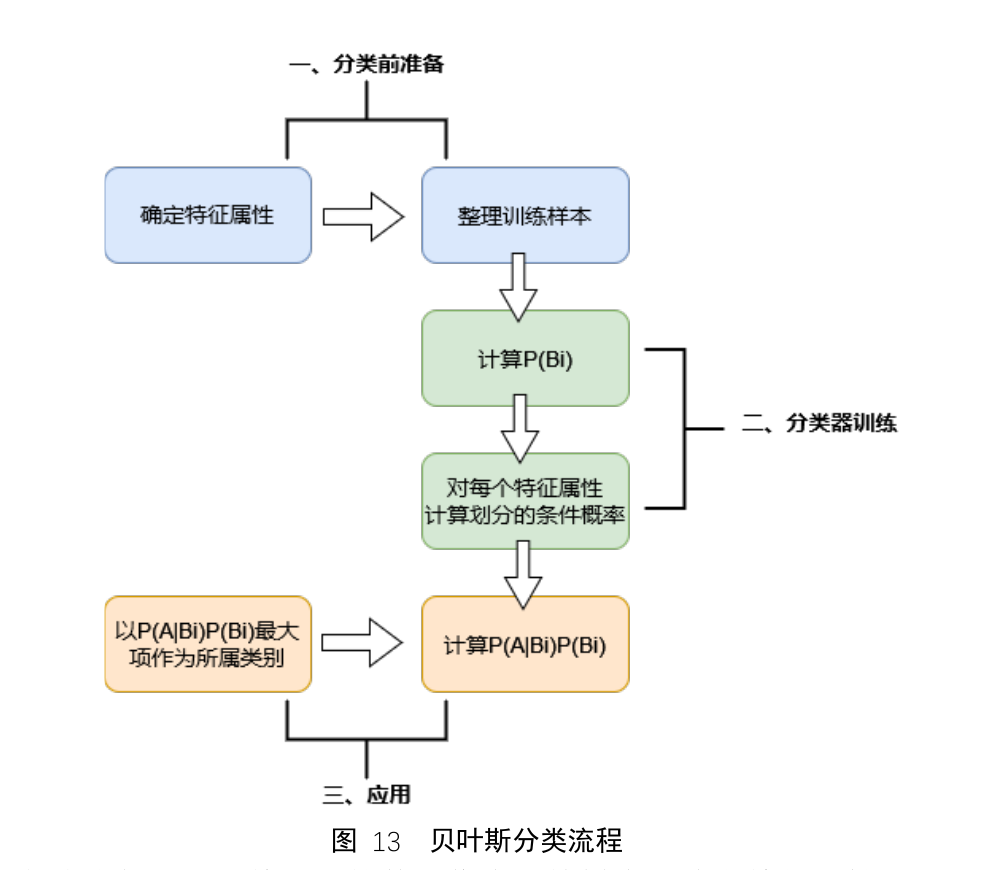
论文图 13:从样本整理、条件概率计算到类别判定的贝叶斯分类流程。