默认提供确定性 Mock,而不是强制调用真实模型
- 为什么这样选
- 评测框架本身需要可复现、可测试,也应允许没有 API Key 的审阅者运行完整流程。
- 没有选择
- 把真实模型 API 设为唯一运行路径
- 取舍
- 当前结果不能代表线上模型效果,但评测逻辑和报告链路可以稳定复核;真实模型适配仍在接入。
把 Golden Set、A/B 对比、Bad Case 与发布门禁组织成可运行评测闭环
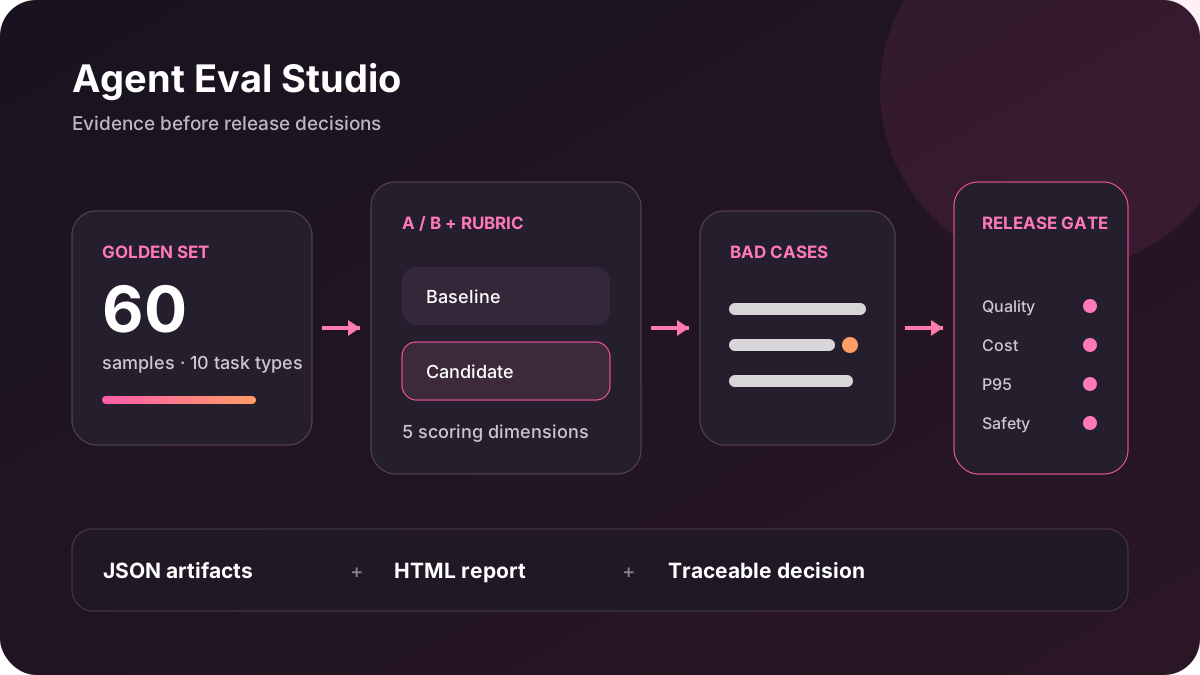
我把“感觉这个 Agent 更好”改造成可复核的发布判断:固定样本与评分口径,对比基线和候选版本,聚合 Bad Case,并用多目标门禁决定是否放行。
固定任务、期望与风险标签。
在同一批样本上执行基线与候选方案。
将多个质量维度转成结构化结果。
按类型定位退化和失败模式。
联合判断质量、成本、P95 与安全。
输出 JSON 工件与可读 HTML 报告。
仓库包含可运行命令、自动化测试、60 条样本、JSON 工件和 HTML 报告。当前 provider 为确定性 Mock,OpenAI-compatible 配置尚未执行真实模型请求。